Google EmbeddingGemma 2 Diperkenalkan untuk Memahami Teks Gambar Audio dan Video
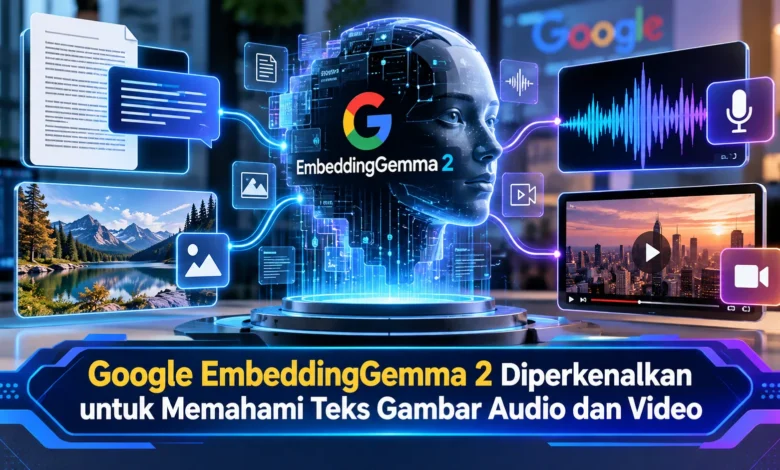
Google kembali menghadirkan inovasi teknologi kecerdasan buatan melalui peluncuran EmbeddingGemma 2 pada 6 Oktober 2026. Model AI terbaru ini dirancang untuk memahami hubungan makna antara teks, gambar, audio, dan video melalui sistem representasi data yang terintegrasi. Berbeda dari model yang hanya berfokus pada satu jenis informasi, EmbeddingGemma 2 memungkinkan pengembang membangun pencarian multimedia yang lebih fleksibel dan efisien. Dengan arsitektur ringan yang dapat dijalankan langsung pada perangkat pengguna, inovasi ini membuka peluang pengembangan aplikasi cerdas tanpa selalu bergantung pada komputasi berbasis cloud. Kehadirannya juga menunjukkan bagaimana teknologi AI semakin diarahkan menuju pemrosesan informasi yang praktis, hemat sumber daya, dan memperhatikan privasi.
Perkembangan Teknologi Multimodal melalui Kehadiran EmbeddingGemma 2
Pengenalan Google EmbeddingGemma 2 merupakan langkah penting dalam evolusi teknologi kecerdasan buatan yang dirancang memahami berbagai jenis informasi secara terintegrasi. Model ini dikembangkan oleh Google DeepMind dengan pendekatan multimodal yang membantu penyatuan informasi semantik dari teks, gambar, audio, dan video. Melalui pendekatan tersebut, pengembang solusi digital dapat mengembangkan fitur pencarian yang lebih fleksibel terhadap berbagai skenario penggunaan. Untuk memberikan gambaran, seseorang bisa menemukan konten visual menggunakan perintah tertulis tanpa mengandalkan label manual secara langsung. Fitur tersebut menawarkan potensi bagi perangkat lunak berbasis AI untuk mengelola informasi dengan lebih efisien.
Salah satu karakteristik utama dari EmbeddingGemma 2 adalah desain arsitektur yang ringan untuk perangkat penggunaan sehari-hari. Google merancang model ini dengan total 740 juta parameter yang tersusun melalui komponen modular. Tidak seperti model dengan miliaran parameter tambahan, EmbeddingGemma 2 dioptimalkan untuk menghasilkan representasi semantik dengan beban komputasi yang lebih terukur. Strategi pengembangan ini menghadirkan manfaat bagi pembuat perangkat lunak desktop yang berencana membangun fitur AI tanpa ketergantungan penuh pada server. Meskipun demikian, kecepatan pemrosesan aktual tetap bergantung pada kemampuan perangkat keras dan jenis data yang diproses.
Cara Kerja Teknologi Multimodal pada EmbeddingGemma 2
Dalam mengenal cara kerja EmbeddingGemma 2, mekanisme penting yang harus dipahami adalah embedding atau representasi numerik. Melalui proses ini, informasi dari beragam format dipetakan ke dalam vektor pada ruang embedding terpadu. EmbeddingGemma 2 menggunakan representasi dengan ukuran dasar 768 dimensi untuk menghubungkan karakteristik informasi dari masukan pengguna. Artinya, kalimat yang menjelaskan suatu benda dapat dipetakan pada posisi semantik yang dekat dengan gambar yang sesuai. Hubungan ini memungkinkan sistem pencarian menelusuri data yang berhubungan meskipun media yang digunakan berlainan. Meski demikian, embedding bukanlah hasil penjelasan lengkap seperti yang ditampilkan sistem AI pembuat teks.
Kemampuan pemrosesan lintas media ini turut memungkinkan kombinasi beberapa bentuk masukan dalam sebuah konteks bersama. Dalam contoh penerapan, database barang digital dapat memadukan deskripsi tertulis, dokumentasi gambar, dan rekaman penggunaan untuk memberikan konteks informasi tambahan. Melalui pengolahan semacam itu, aplikasi dapat mempelajari kedekatan antara berbagai elemen konten tanpa mengharuskan seluruh data berbentuk teks. Pembuat aplikasi setelah itu dapat menggunakan representasi vektor untuk pencocokan kemiripan informasi. Meski terlihat sederhana, kualitas hasil pencarian tetap membutuhkan pengujian berdasarkan kebutuhan aplikasi sebenarnya.
Kemampuan Model AI Google Menghemat Sumber Daya Perangkat
Keunggulan teknis lainnya dari EmbeddingGemma 2 adalah desain komponen yang dapat dipilih berdasarkan kebutuhan pemrosesan. Untuk pengolahan teks, model dapat memanfaatkan komponen dengan jumlah 270 juta parameter. Sementara itu, pengembang dapat memuat encoder visual dengan sekitar 170 juta parameter serta encoder audio dengan sekitar 300 juta parameter. Susunan tersebut memungkinkan penyesuaian dalam mengatur beban perangkat. Dengan demikian, aplikasi yang berfokus pada dokumen tertulis tidak selalu membutuhkan komponen audio dan visual. Hal tersebut menjadi penting untuk laptop dengan memori terbatas.
Selain desain modular, EmbeddingGemma 2 dilengkapi dengan Matryoshka Representation Learning atau MRL yang memungkinkan memperkecil ukuran representasi numerik. Secara bawaan, model menghasilkan embedding 768 dimensi yang dapat dipersingkat menjadi 512, 256, atau 128 dimensi. Pendekatan tersebut membantu menghemat penggunaan ruang database hingga sekitar enam kali lipat ketika memperkecil vektor dari 768 menjadi 128 dimensi. Meskipun menawarkan penghematan, pengurangan dimensi dapat memengaruhi akurasi pencarian dalam kondisi penggunaan tertentu. Karena alasan tersebut, pengujian performa tetap diperlukan sebelum menentukan ukuran vektor pada layanan nyata.
Penerapan EmbeddingGemma 2 dalam Aplikasi dan Layanan Digital
Dalam penerapan praktis, EmbeddingGemma 2 menawarkan berbagai kemungkinan untuk meningkatkan kemampuan pencarian pada perpustakaan konten digital. Sebagai contoh, pengguna yang menyimpan ribuan foto dapat menelusuri dokumentasi visual menggunakan kalimat sederhana. Tanpa harus menelusuri semua berkas secara berurutan, sistem mampu mencocokkan representasi teks dengan vektor foto dalam database. Mekanisme yang sama dapat diterapkan untuk menemukan bagian rekaman berdasarkan perintah tertulis. Melalui kemampuan tersebut, pengelolaan arsip digital dapat berlangsung lebih efisien apabila aplikasi memiliki mekanisme pencocokan yang sesuai.
Di luar pengelolaan arsip, teknologi embedding ini dapat dimanfaatkan untuk fitur pencarian pengetahuan. Untuk kebutuhan edukasi, sistem digital dapat menghadirkan fasilitas yang menautkan informasi pembelajaran dengan gambar ilustrasi. Di lingkungan kerja, perusahaan dengan arsip multimedia dapat mengembangkan penelusuran berbasis makna untuk menghubungkan informasi yang berkaitan. Teknologi ini berpotensi digunakan sebagai bagian dalam retrieval-augmented generation atau RAG, yakni mekanisme pengambilan informasi pendukung. Meskipun menawarkan berbagai manfaat, EmbeddingGemma 2 tidak secara otomatis menghasilkan jawaban lengkap. Ketika membuat aplikasi tanya jawab, model generatif terpisah biasanya tetap diperlukan.
Privasi Data dan Pemrosesan AI Langsung pada Perangkat
Salah satu aspek yang mendapat perhatian dari EmbeddingGemma 2 adalah dukungan terhadap pemrosesan langsung di perangkat. Dengan pendekatan ini, data tertentu dapat dianalisis tanpa selalu menggunakan layanan cloud. Pendekatan tersebut menawarkan manfaat untuk mengurangi perpindahan data sensitif melalui koneksi eksternal. Untuk penggunaan pribadi, aplikasi pencarian foto lokal dapat menyimpan representasi konten di lingkungan komputasi lokal. Potensi perlindungan tersebut cukup penting bagi organisasi dengan kebijakan pengelolaan data. Meski demikian, pengoperasian tanpa cloud tidak secara otomatis menjamin keamanan sepenuhnya.
Agar manfaat privasi dapat diwujudkan, tim pengembang sebaiknya menyiapkan perlindungan terhadap data lokal. Informasi berupa embedding tetap perlu dikelola secara bertanggung jawab karena dapat mencerminkan karakteristik konten. Selain aspek privasi, kemampuan perangkat keras memengaruhi kecepatan pemrosesan. Google menjelaskan bahwa pada konfigurasi terkuantisasi tertentu, kebutuhan RAM aktif untuk bobot model di Pixel 11 Pro dapat berada pada kisaran 191 MB untuk teks saja dan kisaran 567 MB ketika seluruh modalitas digunakan. Kebutuhan memori tersebut tidak dapat disamakan dengan total kebutuhan memori aplikasi karena konfigurasi perangkat lunak dapat memengaruhi pemakaian sumber daya sebenarnya.
Masa Depan EmbeddingGemma 2 dalam Ekosistem Teknologi AI
Kehadiran EmbeddingGemma 2 memperlihatkan perubahan pendekatan pengembangan kecerdasan buatan menuju model yang lebih mudah diintegrasikan. Melalui penerapan arsitektur Gemma 4 dan lisensi Apache 2.0, model ini memberikan ruang bagi pengembang untuk mengembangkan aplikasi pencarian multimodal sesuai kebutuhan produk. Fleksibilitas dalam memproses teks, kode, gambar, audio, dan video turut meningkatkan jenis aplikasi yang dapat dibangun dalam berbagai lingkungan digital. Tidak hanya dari sisi format data, dukungan konteks hingga 8.192 token memberi kapasitas untuk pemrosesan masukan yang lebih panjang dibandingkan pendahulunya. Kapasitas tersebut mendukung analisis terhadap kombinasi teks dan konten visual dalam konfigurasi pemrosesan yang didukung.
Di balik sejumlah keunggulannya, EmbeddingGemma 2 masih memiliki keterbatasan yang harus dievaluasi sebelum diterapkan pada produk nyata. Dalam beberapa kondisi, pengolahan koleksi video yang kompleks dapat membutuhkan pembagian data karena setiap proses memiliki kapasitas input tertentu. Selain itu, kedekatan embedding tidak selalu menjamin ketepatan hasil. Pembuat aplikasi dianjurkan untuk mengevaluasi contoh penggunaan nyata agar pengalaman pengguna dapat ditingkatkan. Dengan evaluasi yang tepat, model ini bisa dimanfaatkan sebagai dasar bagi aplikasi penelusuran konten modern yang lebih responsif terhadap kebutuhan masyarakat digital.
Kesimpulan tentang Google EmbeddingGemma 2 dan Masa Depan Teknologi
Google EmbeddingGemma 2 menunjukkan bahwa kemajuan sistem AI modern terus bergerak menuju representasi data multimodal yang lebih efisien. Melalui dukungan terhadap teks, gambar, audio, dan video dalam representasi semantik terpadu, model ini membuka peluang untuk mengembangkan pencarian multimedia secara lebih terarah. Arsitektur ringan serta optimasi penggunaan memori menawarkan manfaat bagi komunitas pengembang perangkat lunak. Walaupun begitu, perencanaan integrasi tetap perlu diperhatikan untuk menjaga relevansi informasi. Dari sudut pandang Anda, apakah model embedding generasi baru akan membantu aktivitas pengguna sehari-hari? Mari berbagi pemikiran Anda mengenai perkembangan teknologi tersebut.