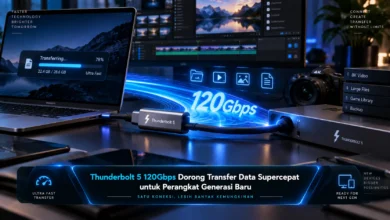
AI Inference Engine Optimization 2026 Jadi Kunci Mempercepat Pemrosesan AI di Perangkat Modern
Perkembangan kecerdasan buatan pada 2026 tidak hanya berfokus pada pembuatan model yang semakin canggih, tetapi juga pada bagaimana model tersebut dapat dijalankan secara cepat dan efisien. AI Inference Engine Optimization menjadi bagian penting karena proses inference menentukan seberapa cepat perangkat menghasilkan respons setelah menerima input. Optimalisasi pada tahap ini semakin relevan ketika teknologi AI hadir di smartphone, laptop, kendaraan, perangkat wearable, kamera pintar, hingga berbagai perangkat edge yang membutuhkan respons cepat dengan konsumsi daya tetap terkendali.
Mengenal AI Inference Engine Optimization dan Fungsinya
AI Inference Engine Optimization menjadi serangkaian teknik untuk membuat proses menjalankan model AI menjadi lebih cepat dan efisien. Setelah sebuah model selesai dilatih, model tersebut perlu menjalankan inference setiap kali menerima input baru. Tahapan ini memiliki pengaruh besar terhadap seberapa responsif teknologi berbasis AI ketika digunakan secara langsung.
Optimalisasi inference bukan sekadar usaha untuk membuat pemrosesan berlangsung lebih cepat. Proses optimalisasi juga harus mempertimbangkan kapasitas memori, efisiensi energi, waktu respons, kemampuan perangkat, serta arsitektur hardware. Keseimbangan berbagai faktor tersebut penting karena model yang sangat cepat belum tentu ideal apabila membutuhkan daya atau memori terlalu besar.
Mengapa Kecepatan Inference Semakin Penting pada 2026
Pertumbuhan fitur kecerdasan buatan yang diproses di perangkat membuat performa inference semakin menentukan pengalaman pengguna. Kemampuan seperti analisis gambar, terjemahan, pengenalan suara, pengeditan konten, AI assistant, serta pemrosesan sensor memerlukan waktu respons yang singkat. Jika proses inference terlalu lambat, pengguna dapat merasakan jeda yang mengurangi kenyamanan ketika berinteraksi dengan perangkat.
Waktu pemrosesan menjadi semakin penting pada aplikasi yang memerlukan respons mendekati real time. Perangkat pintar dapat menerima aliran data dari kamera, mikrofon, sensor gerak, atau komponen lain secara terus menerus. Optimalisasi inference engine memungkinkan data diproses dengan latensi lebih rendah sehingga teknologi dapat menghasilkan tindakan atau informasi dengan lebih cepat.
Quantization Menjadi Teknik Penting untuk Mempercepat AI
Salah satu pendekatan yang dapat digunakan untuk mengoptimalkan inference adalah quantization. Pendekatan ini pada dasarnya menggunakan representasi numerik dengan presisi lebih rendah sehingga kebutuhan memori dan komputasi dapat dikurangi. Dengan penerapan yang terukur, model dapat berjalan lebih ringan dan cepat sekaligus tetap mempertahankan kemampuan yang dibutuhkan.
Walaupun dapat meningkatkan efisiensi, penggunaan presisi rendah membutuhkan evaluasi karena pengurangan yang terlalu besar dapat memengaruhi hasil model. Optimalisasi perlu mempertimbangkan kompromi antara ukuran model, waktu pemrosesan, kebutuhan energi, dan kualitas hasil. Oleh sebab itu, evaluasi langsung pada hardware tujuan menjadi tahapan penting sebelum teknologi diterapkan lebih luas.
Hardware Accelerator Membantu Mempercepat Eksekusi AI
Optimalisasi software akan semakin efektif apabila dapat memanfaatkan kemampuan hardware secara tepat. Perangkat modern dapat memiliki CPU, GPU, NPU, maupun akselerator khusus yang memiliki karakteristik berbeda dalam menjalankan beban kerja AI. Mesin inference perlu mengatur pembagian operasi sehingga komponen hardware dapat digunakan secara efektif.
NPU menjadi semakin relevan karena dirancang untuk menangani berbagai operasi AI dengan efisiensi yang lebih baik pada perangkat tertentu. Namun, performa akhir tetap bergantung pada model, inference engine, driver, compiler, memori, dan bagaimana seluruh komponen tersebut bekerja bersama. Karena itu, peningkatan teknologi AI membutuhkan sinergi antara software dan hardware daripada hanya bergantung pada spesifikasi sebuah komponen.
Inference Engine Efisien Mendukung Pertumbuhan On Device AI
Pemrosesan AI secara lokal menawarkan manfaat seperti respons yang cepat dan kebutuhan koneksi cloud yang lebih rendah untuk beberapa fungsi. Di sisi lain, ponsel, komputer portabel, wearable, serta perangkat edge memiliki keterbatasan daya dan kemampuan membuang panas. Inference yang terlalu berat dapat meningkatkan konsumsi baterai dan menghasilkan panas sehingga pengalaman pengguna menjadi kurang optimal.
Optimalisasi inference engine bertujuan menekan beban komputasi yang tidak diperlukan sambil menggunakan hardware secara lebih efektif. Pendekatan seperti optimalisasi memori, penyederhanaan graph, penggabungan operasi, quantization, dan pengaturan eksekusi dapat membantu meningkatkan performa. Sasaran akhirnya adalah membuat teknologi AI tetap responsif tanpa memberikan beban berlebihan terhadap daya, memori, maupun kemampuan komputasi perangkat.
Optimalisasi Model dan Inference Engine Harus Berjalan Bersama
Kecepatan AI tidak hanya ditentukan oleh seberapa kuat prosesor yang digunakan. Arsitektur model, operasi komputasi, jumlah parameter, format numerik, manajemen memori, compiler, serta runtime ikut menentukan kinerja inference. Dengan demikian, optimalisasi teknologi AI perlu mempertimbangkan keseluruhan pipeline dari model hingga hardware yang menjalankannya.
Tim pengembang dapat mengoptimalkan model dengan mempertimbangkan kemampuan perangkat tujuan. Model yang ditujukan untuk server dengan sumber daya besar mungkin membutuhkan konfigurasi berbeda dibandingkan model yang berjalan pada smartphone atau wearable. Optimalisasi berdasarkan target hardware dapat membantu menghasilkan keseimbangan antara kualitas model, kecepatan inference, efisiensi energi, dan penggunaan memori.
Arah AI Inference Engine Optimization pada Perangkat Modern
AI Inference Engine Optimization 2026 menjadi bagian penting dalam perkembangan AI karena kemampuan model yang tinggi perlu didukung proses eksekusi yang cepat dan efisien. Optimalisasi melalui quantization, pengelolaan memori, graph optimization, operator fusion, compiler, runtime, serta pemanfaatan accelerator dapat membantu mengurangi latensi dan beban komputasi. Peran inference yang efisien semakin besar ketika teknologi kecerdasan buatan hadir langsung di smartphone, komputer, wearable, kendaraan, serta berbagai perangkat edge. Dengan keseimbangan antara model, software, dan hardware, perangkat modern dapat menjalankan kemampuan AI dengan respons lebih cepat sekaligus mempertahankan efisiensi energi. Pembaca juga dapat memantau perkembangan teknologi inference engine untuk memahami bagaimana optimalisasi tersebut membentuk generasi perangkat AI berikutnya.